Apprentissage artificiel et classification non-équilibré pour la cybersecurité
Description du projet
Thématiques de recherche : cybersecurité, intelligence artificielle
Dans le traitement des données volumineuses, il arrive souvent d’avoir plusieurs classes, dont certaines sont très minoritaires, ce qu’on appelle un problème non-équilibré. Par exemple, en classement des documents (par ex : données avec 99% courriel / 1% pourriel), en médicine (3% malades, 97% non), en traitement d’image (par ex : ImageNet avec 1000+ classes), ou grands modèles de langage (par ex : 50 000 tokens = classes), . Les algorithmes d’apprentissage tel que réseaux de neurones peuvent alors être très lents à entraîner, ou bien donner des mauvais résultats pour les classes minoritaires. Nous avons proposé d’améliorer l’apprentissage dans ce cas, grâce à une nouvelle fonction de perte [Hillman and Hocking, 2023]. La méthode dans ce papier marche seulement pour le cas de 2 classes, et dans ce projet de doctorat nous proposons un projet de recherche sur une extension pour le cas de plusieurs classes (3 ou plus), et pour d’autres applications dans la cybersecurité.
Référence : Jonathan Hillman and Toby Dylan Hocking. Optimizing ROC curves with a sort-based surrogate loss for binary classification and changepoint detection. Journal of Machine Learning Research, 24(70):1–24, 2023. jmlr.org/papers/v24/21-0751.html
Rôle de l'étudiante ou de l'étudiant
- Développement de nouveaux algorithmes pour l’analyse efficace des grands jeux de données, surtout pour la classification non-équilibrée, avec applications dans la cybersecurité.
- Rencontres avec professeur toutes les semaines pour discuter le projet.
- Séminaire de recherche avec l’équipe toutes les semaines, pour discuter différents projets de recherche.
- Développement de logiciels libres pour soutenir le projet de recherche.
- Rédaction des papiers de recherche à soumettre pour conférences et journaux.
Candidatures recherchées
Niveaux d'études : Maîtrise et doctorat
Sessions d'entrée : Hiver 2027 ou Automne 2027
Compétences :
- Connaissances en statistiques et l’apprentissage automatique,
- Expérience en programmation, idéalement avec R ou Python, en utilisant des frameworks comme mlr3 et torch.
Atouts considérés :
Les meilleurs candidats auront un profil GitHub témoignant d’une contribution régulière à divers projets de programmation liés à l’analyse de données et à l’apprentissage automatique. Si vous n’avez pas encore de profil GitHub, nous vous recommandons de consulter le manuel https://animint-manual-fr.netlify.app et de réaliser quelques exercices.
Veuillez également consulter les instructions de candidature (https://tdhock.github.io/blog/2024/application) et éviter de copier depuis l’IA, ce qui est plagiat (votre candidature sera alors rejetée).
Direction de recherche
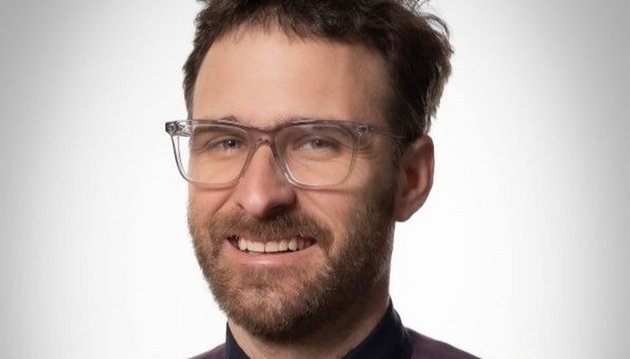
Toby Dylan Hocking
Professeur à l'Université de Sherbrooke
Lieu principal de réalisation
Campus principal de l'Université de Sherbrooke (Pavillon D4)
Unité d'attachement au projet : Faculté des sciences, Département d’informatique, laboratoire LASSO, Université de Sherbrooke
Financement disponible
Bourse d'études de 35 000$/an
Principaux avantages du projet
- Collaborations avec des entreprises
- Rayonnement international
Pourquoi choisir ce projet?
Ce projet vous aidera à développer votre expertise en apprentissage artificiel et logiciels libres pour l’analyse et visualisation de données volumineuses.
Milieu de recherche
Équipe dynamique avec des séminaires de recherche sur différents sujets (apprentissage artificiel, informatique fondamentale, cybersecurité, etc) et opportunités de collaboration avec d’autres labos universitaires, et avec entreprises.